Ako spustiť lokálny AI model na vlastnom počítači
Návod, ako si spustiť lokálny AI model na vlastnom počítači cez Ollama a Open WebUI a ako vybrať model podľa pamäte. Postup sme prešli sami a zmerali rýchlosť aj spotrebu RAM.
ChatGPT a podobné služby bežia na serveroch niekoho iného. Všetko, čo do nich napíšete, odchádza cez internet. Lokálny AI model je jazykový model (LLM), ktorý beží priamo na vašom počítači. Funguje aj bez internetu a texty neopustia váš disk.
V tomto návode ukážeme, ako si lokálny model spustiť pomocou bezplatného nástroja Ollama, ako k nemu pridať chatovacie okno a hlavne ako vybrať model, ktorý váš počítač utiahne. Celý postup sme si najprv prešli sami: na testovacom serveri s Debianom 13, 8 vCPU Intel Xeon a 16 GB RAM, bez grafickej karty. Nainštalovali sme Ollama 0.40.7 a Open WebUI 0.12.3, spustili šesť modelov a zmerali rýchlosť aj spotrebu pamäte. Všetky screenshoty sú z tohto testu (21. 10. 2026).
Krátka odpoveď
- Najjednoduchší začiatok je Ollama: nainštalujete ho, napíšete
ollama run názov-modelua model sa stiahne a spustí. - O tom, aký model spustíte, rozhoduje hlavne pamäť: RAM, ak nemáte grafickú kartu, alebo VRAM grafiky. Model musí do pamäte celý vojsť aj s rezervou na rozhovor.
- Na počítači s 8 GB RAM rozumne pobežia modely do približne 3 až 4 miliárd parametrov, so 16 GB modely okolo 7 až 9 miliárd (podľa odporúčaní nástroja Jan).
- Malé modely sú rýchle, ale po slovensky v našom teste písali s množstvom chýb. Použiteľný slovenský text dal až model s 9 miliardami parametrov.
- Ollama počúva v predvolenom nastavení len na vašom počítači (127.0.0.1). Nesprístupňujte ho do internetu bez ochrany.
Kedy má lokálny AI model zmysel
Lokálny model sa hodí, keď pracujete s textami, ktoré nechcete posielať do cloudu (interné dokumenty, zmluvy, e-maily zákazníkov), keď potrebujete fungovať offline, alebo keď chcete AI vyskúšať bez mesačného predplatného. Ollama to v dokumentácii hovorí priamo: pri lokálnom behu nevidí vaše prompty ani dáta (Ollama FAQ).
Počítajte ale s kompromisom. Modely, ktoré utiahne bežný notebook, sú menšie ako tie, čo bežia v cloude. Sú pomalšie a robia viac chýb, najmä v slovenčine. Na zhrnutie textu, návrh e-mailu alebo prácu s vlastnými dokumentmi to stačiť môže. Na náročné úlohy často nie.
Čo potrebujete: pamäť, kvantizácia a veľkosť modelu
Veľkosť modelu sa udáva v miliardách parametrov (napríklad 3B alebo 9B). Každý parameter je číslo, ktoré treba držať v pamäti. Aby sa modely zmestili do bežného počítača, ukladajú sa kvantizované, teda s menej presnými číslami. Formát GGUF, ktorý používa Ollama, LM Studio aj GPT4All, podporuje kvantizácie od zhruba 1,5 bitu po 16 bitov na váhu (Hugging Face).
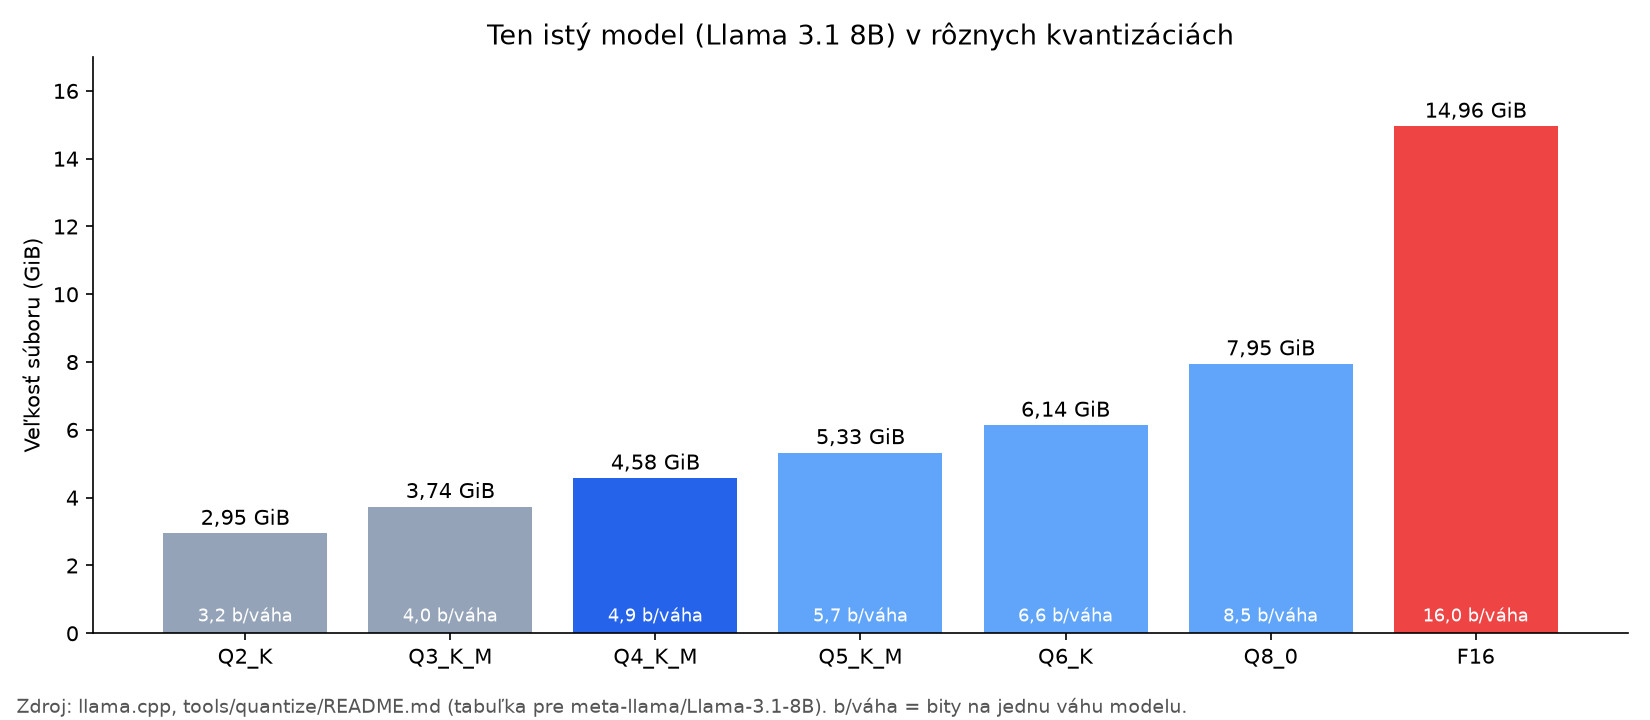
Ako veľmi kvantizácia zmenšuje model, ukazuje tabuľka z projektu llama.cpp pre model Llama 3.1 8B: v plnej 16-bitovej presnosti má súbor 14,96 GiB, v kvantizácii Q4_K_M 4,58 GiB a v Q8_0 7,95 GiB (llama.cpp). Model llama3.2:3b v knižnici Ollama je predvolene práve v Q4_K_M a má 2,0 GB (Ollama library).
K samotnému súboru treba pripočítať pamäť na rozhovor (kontext) a pre operačný systém. V našom teste zabral model llama3.2:3b s veľkosťou 2,0 GB po načítaní 2,9 GB podľa príkazu ollama ps a z toho 448 MiB pripadlo na kontext 4 096 tokenov (log Ollama). Väčší kontext znamená viac pamäte. Ollama uvádza, že pamäť rastie aj s počtom súčasných požiadaviek (Ollama FAQ).
Tabuľka: aký model utiahne váš počítač
Veľkosti sú z knižnice Ollama (predvolené kvantizácie), odporúčania pamäte z oficiálnych zdrojov uvedených v tabuľke. Pri počítači bez grafiky platí riadok podľa RAM, pri grafickej karte podľa VRAM a na Macu s čipom M podľa zjednotenej pamäte.
| Pamäť (RAM / VRAM) | Čo odporúčajú zdroje | Príklady modelov (veľkosť na disku) |
|---|---|---|
| 8 GB | modely do 3B (Jan, údaj pre macOS) | gemma3:1b (0,8 GB), llama3.2:3b (2,0 GB), qwen3.5:4b (3,3 GB) |
| 16 GB | modely okolo 7B (Jan, macOS); gpt-oss-20b beží „v rámci 16 GB pamäte“ (OpenAI, model card) | llama3.1:8b (4,9 GB), qwen3.5:9b (6,6 GB), gemma4:12b (7,7–8,0 GB) |
| 32 GB | modely okolo 13B (Jan, macOS) | qwen3:14b (9,3 GB), gemma4:26b (16–19 GB), qwen3.5:27b (17–20 GB) |
| 64 GB a viac | väčšie modely, ktoré sa do 32 GB nezmestia | gemma4:31b (19–20 GB), qwen3.5:35b (22 GB), qwen3.5:122b (81 GB) |
Tabuľku môžete posunúť do strany.
Prakticky pravidlo z nášho testu: súbor modelu by mal byť aspoň o tretinu menší, ako je voľná pamäť. Ak model do VRAM grafiky nevojde, Ollama ho rozdelí medzi grafiku a RAM a beží pomalšie. Príkaz ollama ps to ukáže v stĺpci PROCESSOR, napríklad 48%/52% CPU/GPU (Ollama FAQ).
Ktorý nástroj vybrať
Všetky nasledujúce nástroje sú zadarmo a pod kapotou väčšinou používajú llama.cpp alebo jeho formát GGUF. Líšia sa hlavne tým, či uprednostňujete okno s tlačidlami, alebo príkazový riadok.
| Nástroj | Čo to je | Systémy | Licencia |
|---|---|---|---|
| Ollama | služba a príkazový riadok, API na localhost:11434 | Windows, macOS, Linux | MIT |
| LM Studio | aplikácia s grafickým rozhraním | macOS (len Apple Silicon), Windows, Linux | uzavretá, od júla 2025 zadarmo aj na prácu (LM Studio) |
| Jan | aplikácia s grafickým rozhraním | Windows, macOS, Linux | Apache 2.0 |
| GPT4All | aplikácia, funkcia LocalDocs na prácu s dokumentmi | Windows, macOS, Linux (len x86-64) | MIT; posledná zmena na GitHube máj 2025 |
| Open WebUI | webové chatovacie okno nad Ollamou | kdekoľvek beží Python alebo Docker | vlastná licencia, nad 50 používateľov nesmiete odstrániť jej značku |
| llama.cpp | engine pre pokročilých | Windows, macOS, Linux | MIT |
Tabuľku môžete posunúť do strany.
Ak chcete len skúsiť, ako to funguje, a nechcete otvárať terminál, LM Studio alebo Jan sú najrýchlejšia cesta. Ak chcete model napojiť na ďalšie programy alebo sprístupniť kolegom, Ollama s Open WebUI je praktickejšia kombinácia. Tú sme testovali.
Návod: Ollama krok za krokom (náš test na Linuxe)
1. Inštalácia
Na Linuxe sa Ollama inštaluje jedným príkazom z oficiálnej dokumentácie (Ollama, Linux):
curl -fsSL https://ollama.com/install.sh | shPri prvom pokuse inštalácia na našom Debiane skončila chybou, lebo chýbal program zstd na rozbalenie balíka. Po jeho doinštalovaní prešla bez problémov.
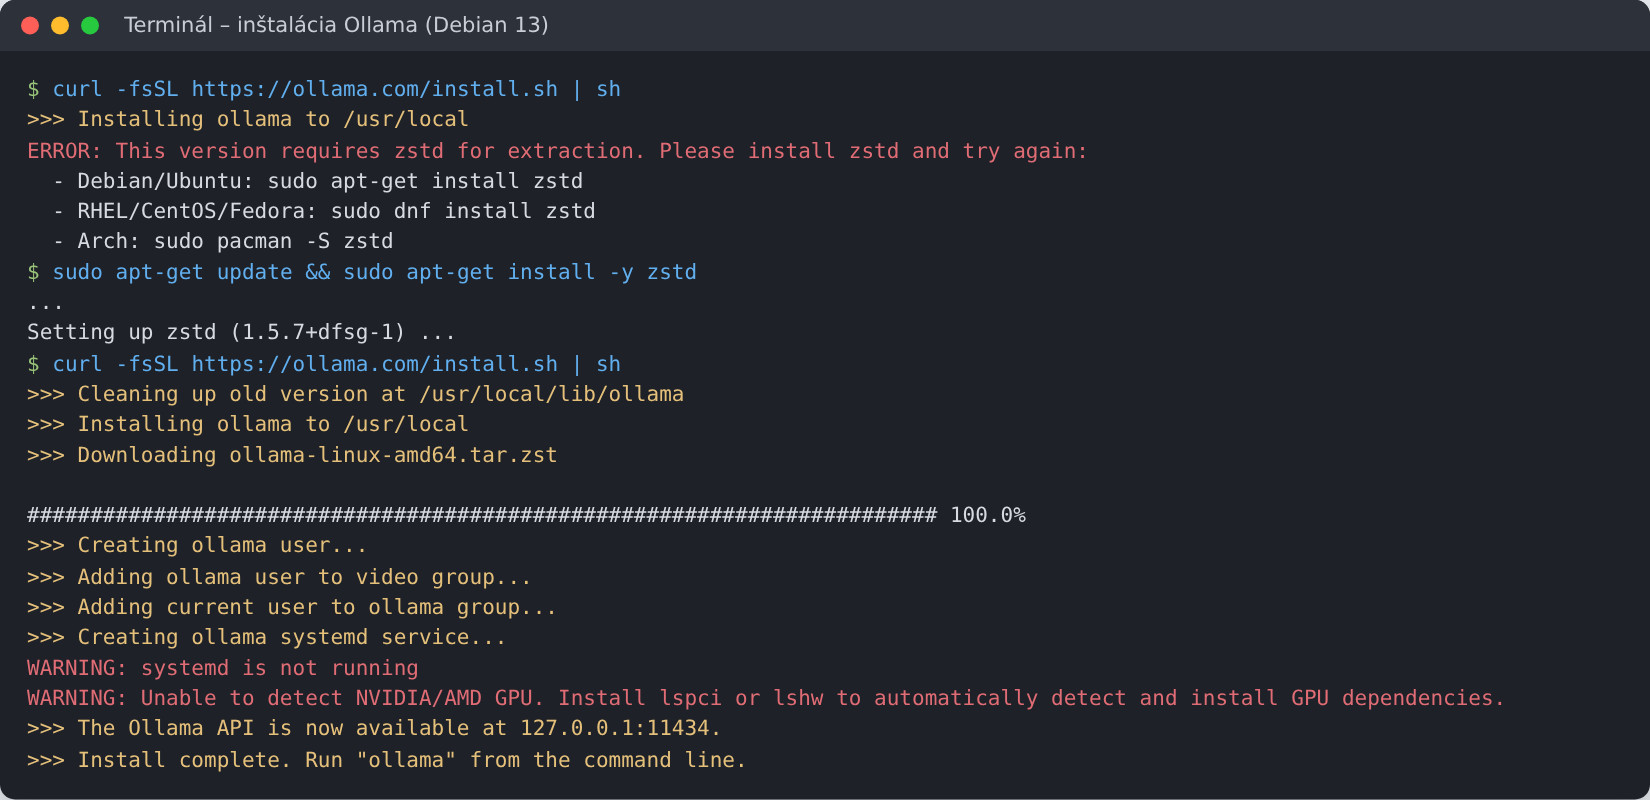
Inštalátor bežne vytvorí systémovú službu, ktorá Ollama spúšťa automaticky. Náš testovací server systemd nemá, preto sme službu spustili ručne príkazom ollama serve. Inštalátor tiež nenašiel grafickú kartu, takže všetko bežalo len na procesore.
2. Stiahnutie modelu
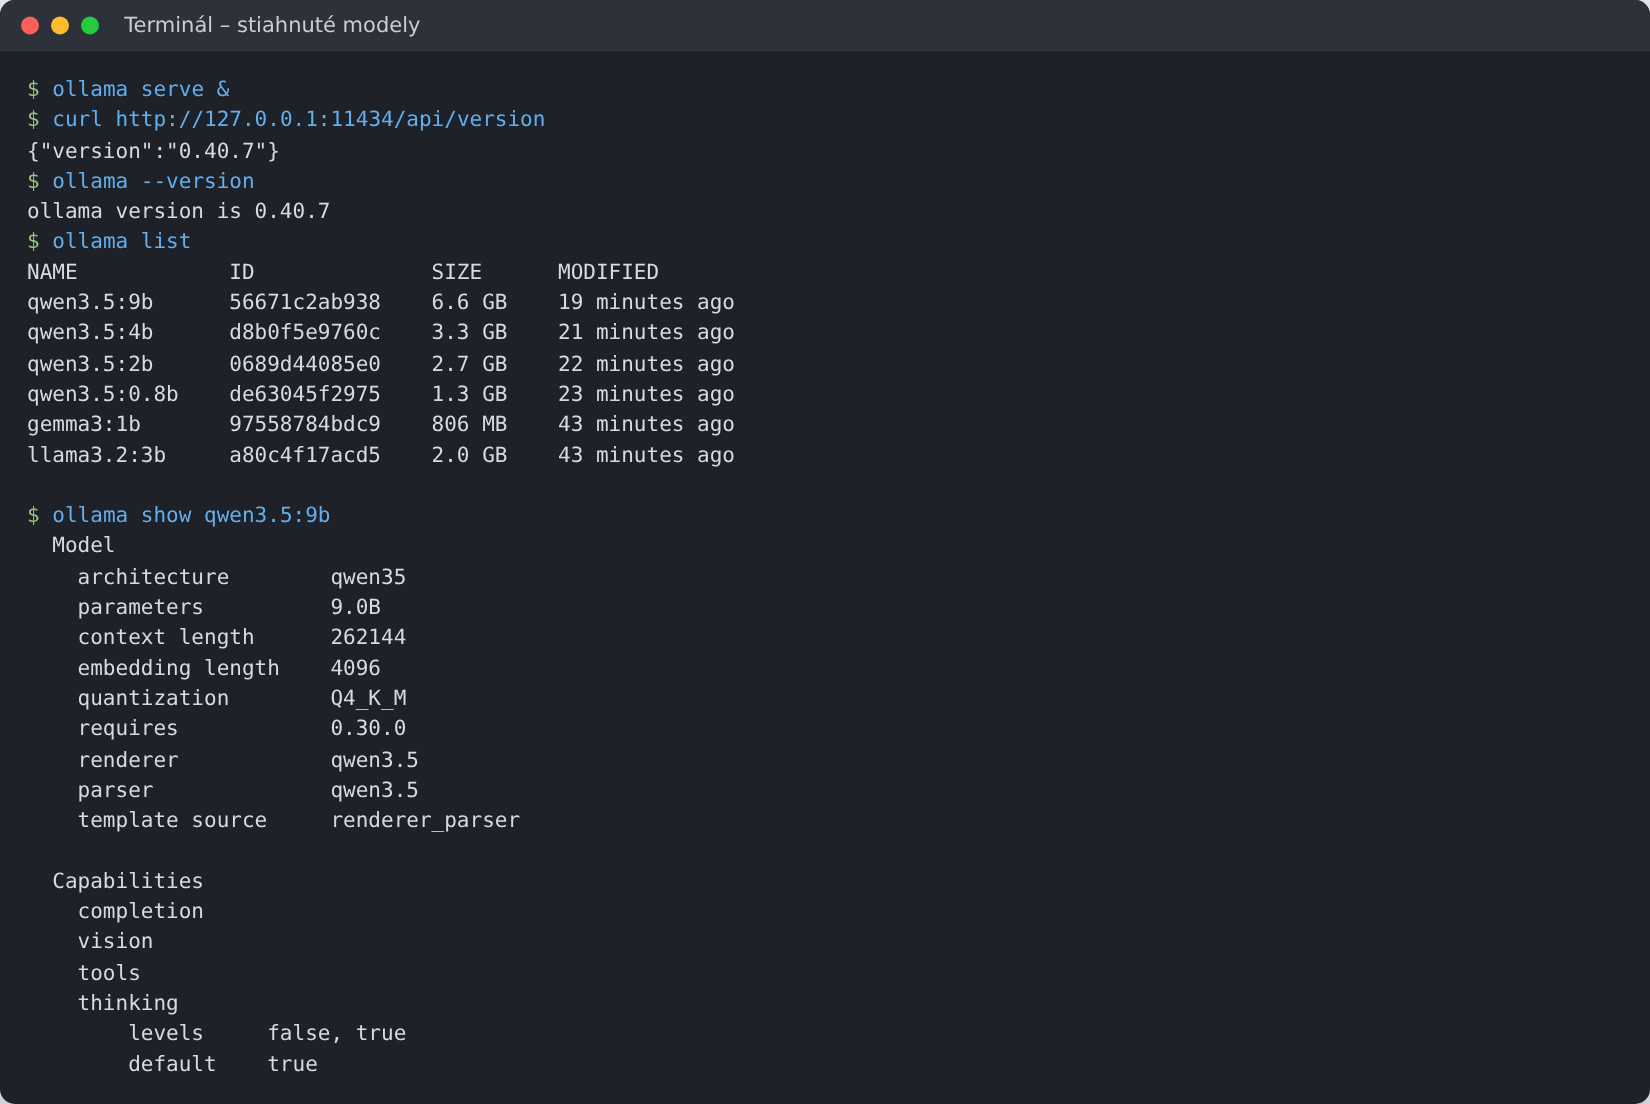
Model stiahnete príkazom ollama pull qwen3.5:9b alebo rovno spustíte ollama run qwen3.5:9b, ktorý ho stiahne sám. Zoznam modelov nájdete v knižnici Ollama.
Úprimne: v našom testovacom prostredí ollama pull zlyhal, lebo sieť servera blokovala presmerovanie na úložisko modelov. Rovnaké súbory sme preto stiahli z registra Ollama ručne a skontrolovali ich kontrolné súčty. Na bežnom počítači tento krok nepotrebujete.
3. Prvý rozhovor a meranie rýchlosti
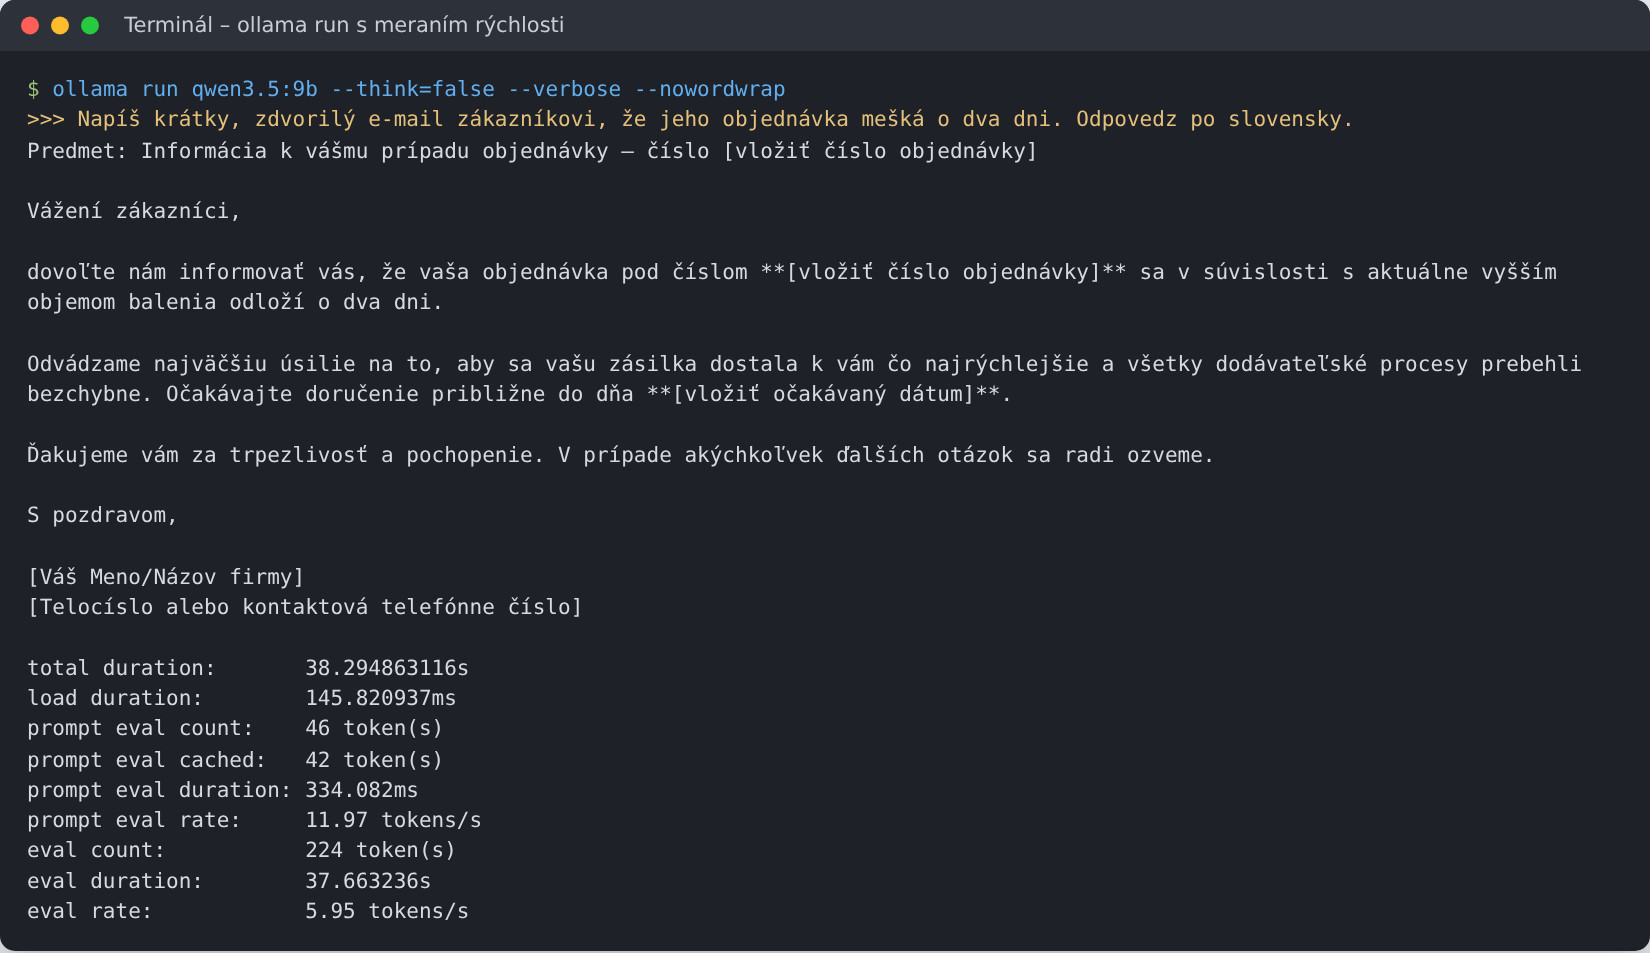
Model spustíte príkazom ollama run. S prepínačom --verbose vypíše na konci aj rýchlosť. Hodnota eval rate hovorí, koľko tokenov (častí slov) model vygeneruje za sekundu.
4. Kontrola pamäte
Príkaz ollama ps ukáže, ktoré modely sú načítané a koľko pamäte zaberajú. Načítaný model sa po piatich minútach nečinnosti sám uvoľní, hneď to urobíte príkazom ollama stop (Ollama FAQ).
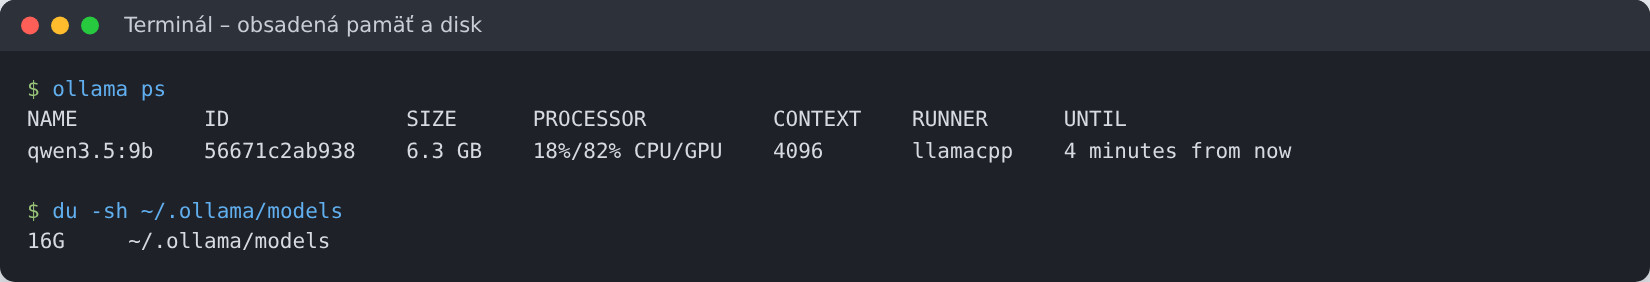
Pozor na stĺpec PROCESSOR: aj keď náš server nemá grafickú kartu, ukazuje „18%/82% CPU/GPU“. Podľa logu Ollama sa väčšina modelu načítala do pamäte pre maticovú jednotku AMX, ktorú má priamo procesor Intel Xeon. Ollama ju zrejme preto zobrazuje ako „GPU“. Grafická karta to nie je. Bežný notebook takú jednotku zvyčajne nemá, preto berte naše rýchlosti ako orientačné.
Windows a Mac (netestovali sme)
Na Windows a Macu sme postup neskúšali, preto len zhrnutie z oficiálnej dokumentácie:
- Windows: stiahnete
OllamaSetup.exe, inštalácia nevyžaduje administrátora. Potrebujete Windows 10 22H2 alebo novší a pre grafiky NVIDIA ovládač 551.61 alebo novší (Ollama, Windows). - macOS: stiahnete
ollama.dmga aplikáciu presuniete do Aplikácií. Potrebujete macOS 14 Sonoma alebo novší. Na čipoch M Ollama využije aj grafiku, na starších Macoch s Intelom len procesor (Ollama, macOS). - Grafické karty: NVIDIA s compute capability 5.0 a vyšším, vybrané AMD Radeon cez ROCm a ďalšie karty cez Vulkan (Ollama, hardvér). Na grafike sme netestovali, takže rýchlosť s GPU vám nevieme potvrdiť.
Chatovacie okno: Open WebUI
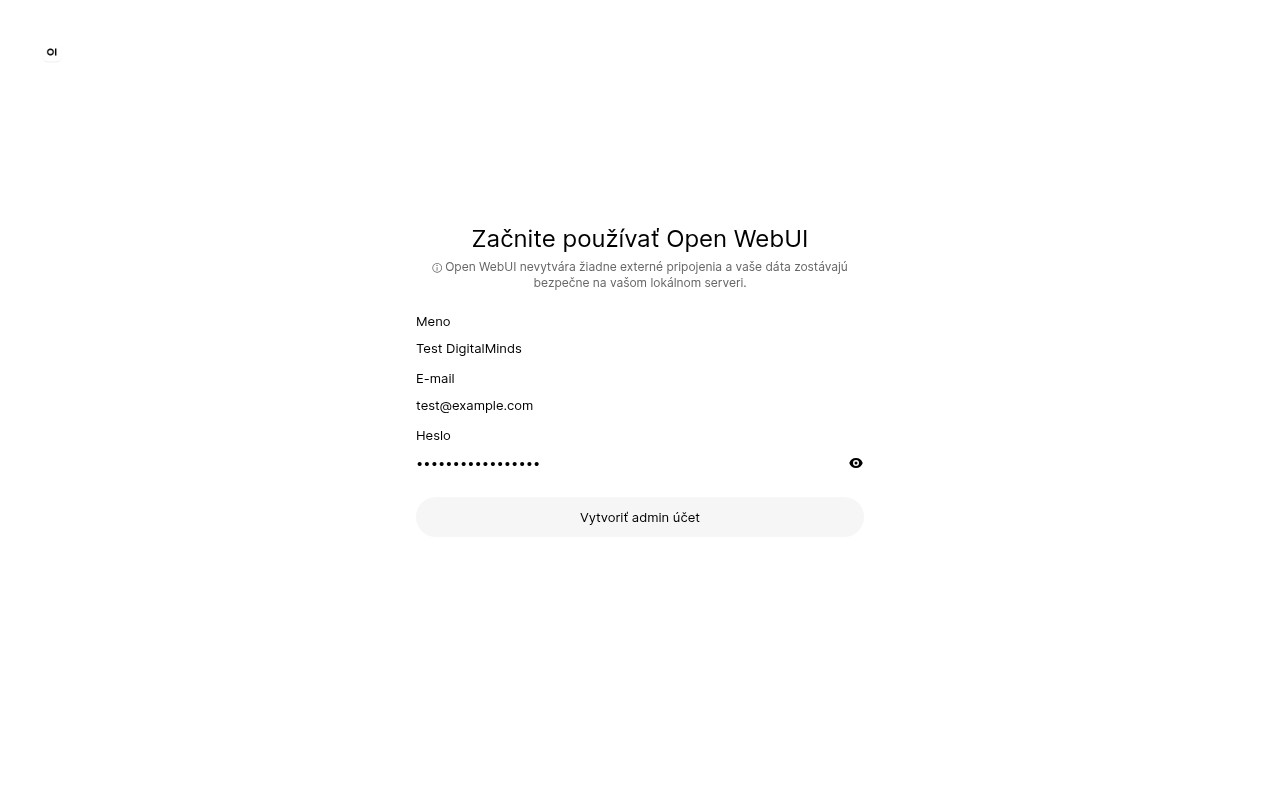
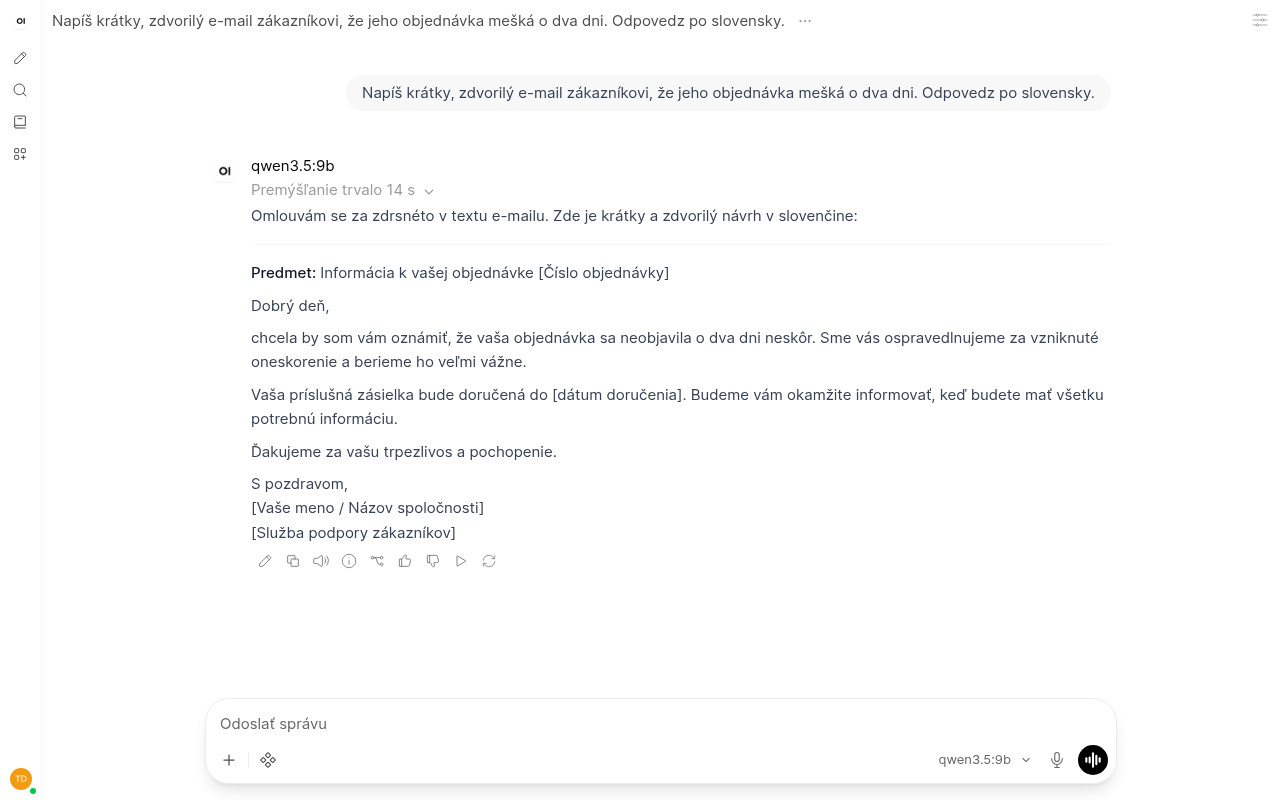
Príkazový riadok nie je pre každého. Open WebUI pridá k Ollame chatovacie okno v prehliadači, ktoré vyzerá podobne ako ChatGPT a má aj slovenský preklad. Nainštalovali sme ho cez pip install open-webui a spustili príkazom open-webui serve. Rozhranie potom beží na adrese http://localhost:8080.
Prvý používateľ, ktorý sa zaregistruje, sa stane administrátorom. Účet sa ukladá len v lokálnej databáze.
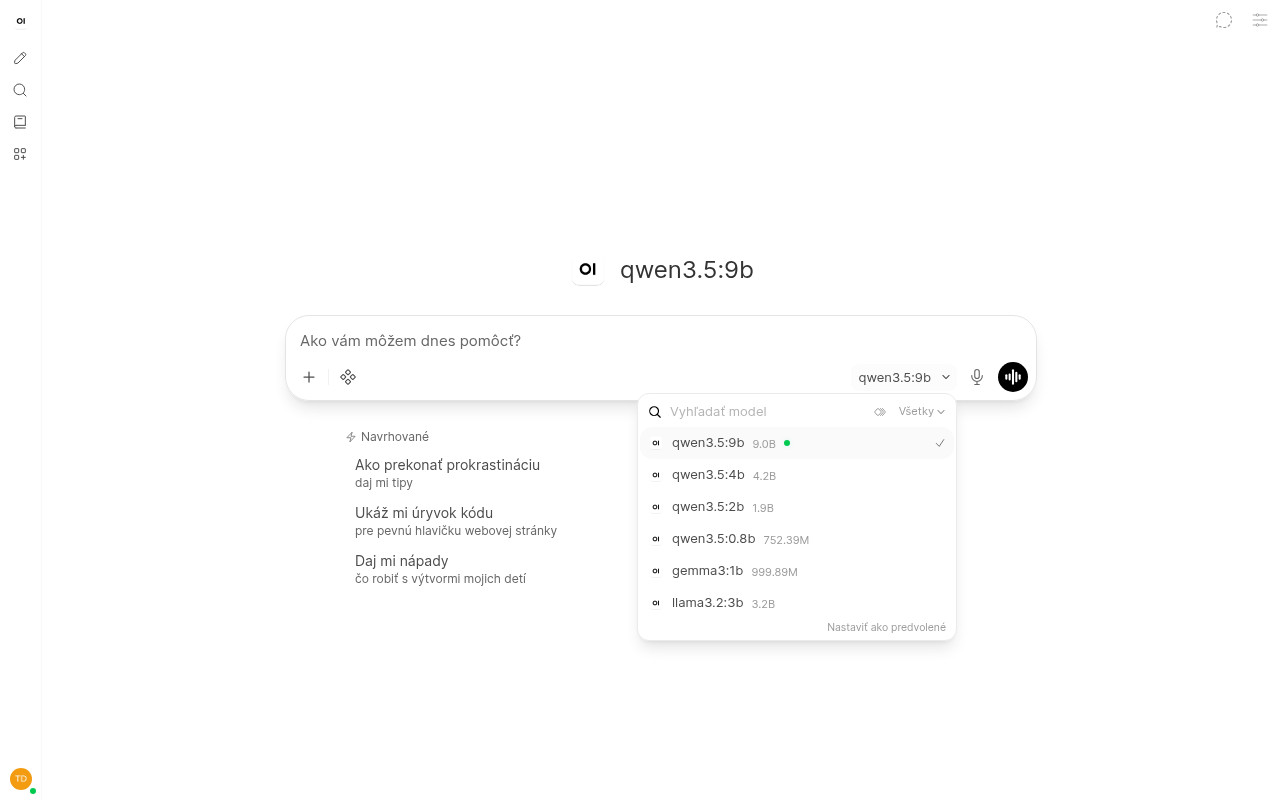
Modely stiahnuté v Ollame sa v Open WebUI objavia samé, netreba nič nastavovať.
Čo sme namerali
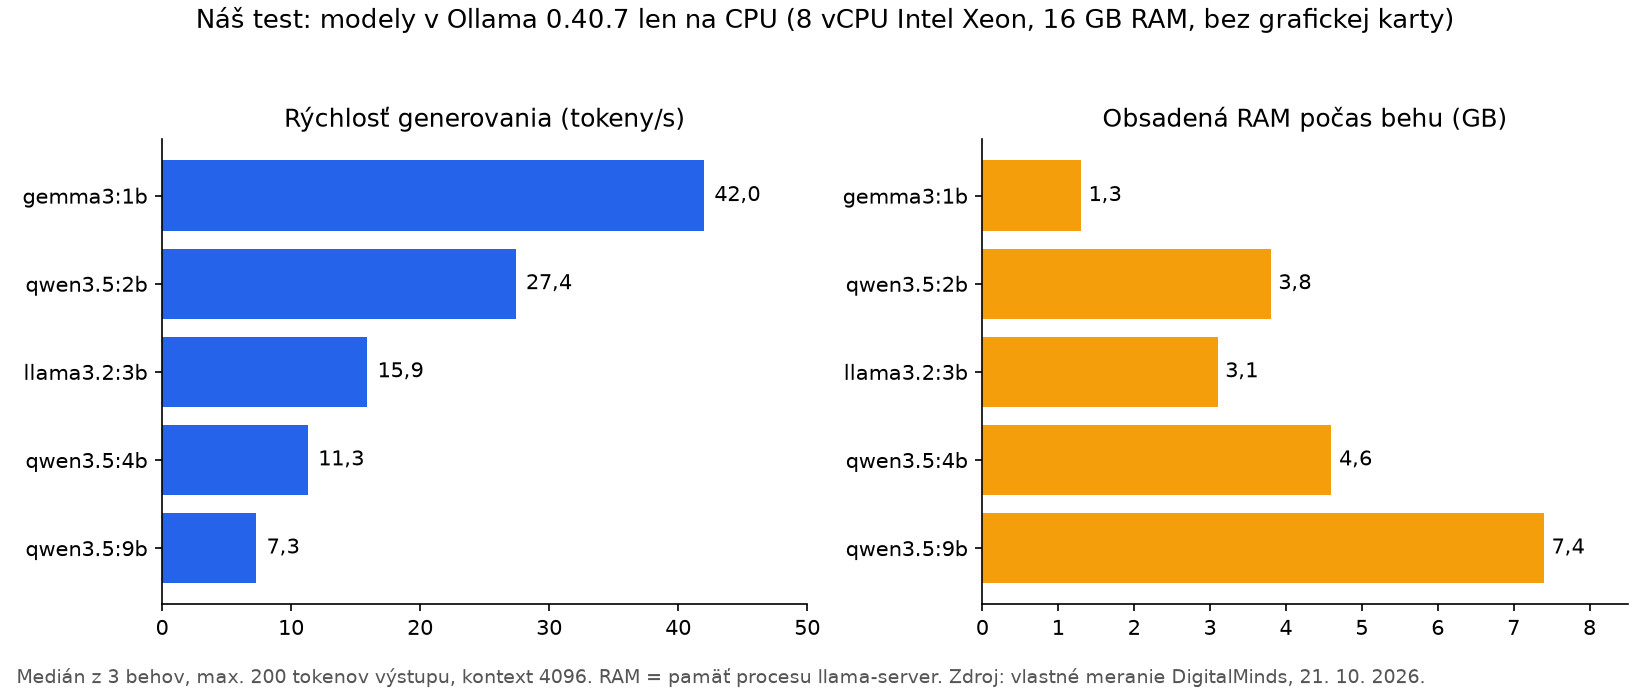
Všetkým šiestim modelom sme zadali rovnakú úlohu po slovensky (krátky e-mail zákazníkovi o meškajúcej objednávke) a každú zopakovali štyrikrát. Rýchlosť je medián z posledných troch behov, pamäť je skutočná RAM procesu, ktorý model obsluhoval. Hodnotenie slovenčiny je náš subjektívny dojem z jednej úlohy, nie benchmark.
| Model | Licencia | Na disku | RAM počas behu | Prvé načítanie | Rýchlosť | Slovenčina v našom teste |
|---|---|---|---|---|---|---|
| gemma3:1b | Gemma Terms of Use | 0,8 GB | 1,3 GB | 3,3 s | 42,0 tok/s | veľa chýb, nezrozumiteľné vety |
| qwen3.5:0.8b | Apache 2.0 | 1,3 GB | 2,5 GB | 6,2 s | 4,6 tok/s* | nezmyselný text |
| qwen3.5:2b | Apache 2.0 | 2,7 GB | 3,8 GB | 6,4 s | 27,4 tok/s | veľa chýb, miešanie s češtinou |
| llama3.2:3b | Llama 3.2 Community License | 2,0 GB | 3,1 GB | 7,9 s | 15,9 tok/s | nepoužiteľné, opakovanie viet |
| qwen3.5:4b | Apache 2.0 | 3,3 GB | 4,6 GB | 9,4 s | 11,3 tok/s | lepšia gramatika, obsah mimo zadania |
| qwen3.5:9b | Apache 2.0 | 6,6 GB | 7,4 GB | 14,7 s | 7,3 tok/s | použiteľný koncept s drobnými chybami |
Tabuľku môžete posunúť do strany.
* Model qwen3.5:0.8b bol na našom procesore neočakávane pomalý, opakovane okolo 5 tokenov za sekundu. Príčinu sme nezisťovali, preto ho v grafe neuvádzame.
Tri veci, ktoré nás prekvapili:
- Veľkosť na disku nie je celá spotreba. Modely qwen3.5 obsahujú aj časť na čítanie obrázkov a menšie verzie sú v presnejšej kvantizácii Q8_0. Preto qwen3.5:2b zabral viac pamäte ako väčší llama3.2:3b.
- Slovenčina je pre malé modely problém. Pod 4 miliardy parametrov sme nedostali text, ktorý by sa dal poslať zákazníkovi. Ani 9B model nebol bez chýb, výstup treba vždy prečítať.
- Na procesore sa to dá, ale trpezlivo. Pri 7 tokenoch za sekundu písal model qwen3.5:9b krátky e-mail takmer 40 sekúnd.
Ako vybrať model pre váš počítač
- Zistite si pamäť. Na Windows v Správcovi úloh, na Macu v časti O tomto Macu. Ak máte grafickú kartu, rozhoduje jej VRAM.
- Vyberte veľkosť podľa tabuľky vyššie a začnite skôr menším modelom. Väčší skúsite, keď uvidíte, ako počítač zvláda menší.
- Pozrite sa na licenciu. Qwen 3.5, Gemma 4 aj gpt-oss sú pod Apache 2.0 (Qwen, Google, OpenAI). Gemma 3 má vlastné podmienky používania. Licencia Llama 3.2 neudeľuje práva k jej multimodálnym (obrazovým) modelom osobám a firmám so sídlom v EÚ. Textové verzie 1B a 3B sa toho netýka (Llama 3.2 Acceptable Use Policy, súčasť balíka modelu v Ollame).
- Otestujte ho na vlastnej úlohe. Benchmarky v kartách modelov sú prevažne v angličtine. Dajte modelu tri až päť typických úloh z vašej práce po slovensky a porovnajte.
Bezpečnosť a firemné použitie v skratke
Lokálny beh rieši hlavne to, že dáta neodchádzajú k poskytovateľovi AI. Neznamená to automaticky bezpečnosť. Tejto téme sa budeme podrobne venovať v samostatnom článku, tu sú len základy:
- Nesprístupňujte Ollama do internetu. Rozhranie Ollama v predvolenom stave počúva len na 127.0.0.1 a pri zmene adresy cez
OLLAMA_HOSTnepridá žiadne prihlasovanie (Ollama FAQ). Cisco Talos v roku 2025 našiel cez vyhľadávač Shodan 1 139 verejne dostupných serverov Ollama, z toho 214 odpovedalo bez akéhokoľvek overenia (Cisco). - Poznajte typické riziká. OWASP Top 10 pre LLM aplikácie 2025 uvádza na prvých miestach prompt injection, únik citlivých informácií a riziká dodávateľského reťazca, teda aj modely stiahnuté z neoverených zdrojov (OWASP). Sťahujte modely z oficiálnych knižníc a od pôvodných autorov.
- GDPR platí aj lokálne. Ak model spracúva osobné údaje zákazníkov alebo zamestnancov, ste za to zodpovední ako prevádzkovateľ a musíte ich primerane zabezpečiť (nariadenie GDPR, čl. 32). Lokálny model vám ušetrí riešenie sprostredkovateľa a prenosu údajov mimo EÚ, nie ostatné povinnosti.
- Overujte výstupy. Ako ukázal náš test, model sa mýli aj v jednoduchom e-maile. Do firemného procesu patrí kontrola človekom.
Časté otázky
Potrebujem na lokálny AI model grafickú kartu?
Nie. Všetky naše merania bežali len na procesore. Grafická karta s dostatkom VRAM však výrazne zrýchli generovanie a umožní väčšie modely.
Je lokálny model tak dobrý ako ChatGPT?
Modely, ktoré utiahne bežný počítač, sú menšie a v slovenčine slabšie. Na zhrnutia, koncepty a prácu s vlastnými textami môžu stačiť. Kvalitu si overte na vlastných úlohách.
Koľko miesta na disku potrebujem?
Podľa modelu od menej ako 1 GB po desiatky GB. Našich šesť testovaných modelov zabralo spolu 16 GB a samotná inštalácia Ollama na Windows potrebuje aspoň 4 GB (Ollama, Windows).
Funguje to bez internetu?
Áno. Internet potrebujete len na stiahnutie programu a modelov. LM Studio vo svojej dokumentácii tiež uvádza, že po stiahnutí modelov funguje úplne offline (LM Studio).
Môžem lokálny model používať vo firme?
Nástroje Ollama, Jan, GPT4All a llama.cpp sú open source, LM Studio je od júla 2025 zadarmo aj na prácu. Skontrolujte však licenciu konkrétneho modelu a nastavte, kto a s akými dátami k nemu pristupuje.
Zhrnutie
Spustiť lokálny AI model je dnes otázka niekoľkých minút: nainštalujete Ollama, stiahnete model a prípadne pridáte Open WebUI. Ťažšie je vybrať model, ktorý váš počítač utiahne a ktorý zároveň zvládne slovenčinu. S 8 GB RAM sa držte modelov do 4B, so 16 GB skúste 7B až 9B a výstupy vždy čítajte.
Chcete lokálnu AI vo firme, napríklad na prácu s internými dokumentmi, a neviete, aký hardvér a model zvoliť? Pomôžeme vám s výberom aj nastavením, pozrite si našu integráciu AI. Na bezplatnej 30-minútovej konzultácii spolu prejdeme, na čo ju chcete používať a či vám stačí lokálny model.
Zdroje
- Ollama: Linux, Windows, macOS, Hardware support, FAQ (stav k 21. 10. 2026)
- Ollama library: llama3.2, qwen3.5, gemma4 a manifesty registra Ollama pre llama3.1, qwen3, gpt-oss (veľkosti modelov)
- llama.cpp: Quantize README
- Hugging Face: GGUF; karty modelov Qwen3.5-9B, Gemma 4 E4B, gpt-oss-20b
- LM Studio: System Requirements, Free for use at work (8. 7. 2025), App Terms (verzia 23. 8. 2026)
- GitHub: Jan, GPT4All, Open WebUI (licencia), Ollama
- Meta: Llama 3.2 Community License a Acceptable Use Policy (súčasť modelu llama3.2 v Ollama)
- Cisco: Detecting Exposed LLM Servers: A Shodan Case Study on Ollama (1. 9. 2025)
- OWASP: Top 10 for LLM Applications 2025
- Nariadenie (EÚ) 2016/679 (GDPR)
- Vlastný test DigitalMinds, 21. 10. 2026: Debian 13, 8 vCPU Intel Xeon (AMX), 16 GB RAM, bez GPU; Ollama 0.40.7, Open WebUI 0.12.3.
Potrebujete web, ktorý bude váš?
Na 30-minútovej konzultácii povieme, či stačí firemný web od 690 €, Business, e-shop, alebo niečo iné. Konzultácia je zdarma.